微服务架构中接口网关与负载均衡软件的协同配置方案
网关与负载均衡:微服务入口的双重困境
当单体应用拆分为几十乃至上百个微服务后,团队最先撞上的墙往往不是业务逻辑本身,而是流量入口的失控。开发人员发现,鉴权逻辑在每个服务里重复实现,灰度发布需要运维手动改Nginx配置,而某个下游服务的抖动会像多米诺骨牌一样拖垮整个调用链。此时,接口网关软件与负载均衡软件的协同,便从“可选项”变成了“生存刚需”。
问题根源在于职责混淆。很多团队把负载均衡软件(如Nginx、HAProxy)当作万能入口,既做四层转发又做七层路由,甚至硬塞进限流规则——结果配置臃肿不堪,每次变更都如履薄冰。而接口网关软件(如Kong、APISIX)虽擅长协议转换、认证聚合,但其底层的连接管理与线程模型,在应对突发流量时远不如专用负载均衡器高效。两者并非替代关系,而是“前置分发”与“后置治理”的分工协作。
协同配置的技术锚点:一场关于“位置”的博弈
理想的拓扑通常是:负载均衡软件置于最前端,承担TLS终止、连接保活、IP哈希等基础网络职能;接口网关软件紧随其后,专注路由匹配、JWT校验、请求/响应转换。但这里有一个常被忽视的细节——健康检查的粒度。负载均衡器若仅探测网关进程的TCP端口,无法感知网关内部到下游服务的连接池是否已耗尽。实践中,我们建议在网关的/admin/health端点返回上游服务聚合状态,让负载均衡据此摘除“半死”节点,避免流量黑洞。
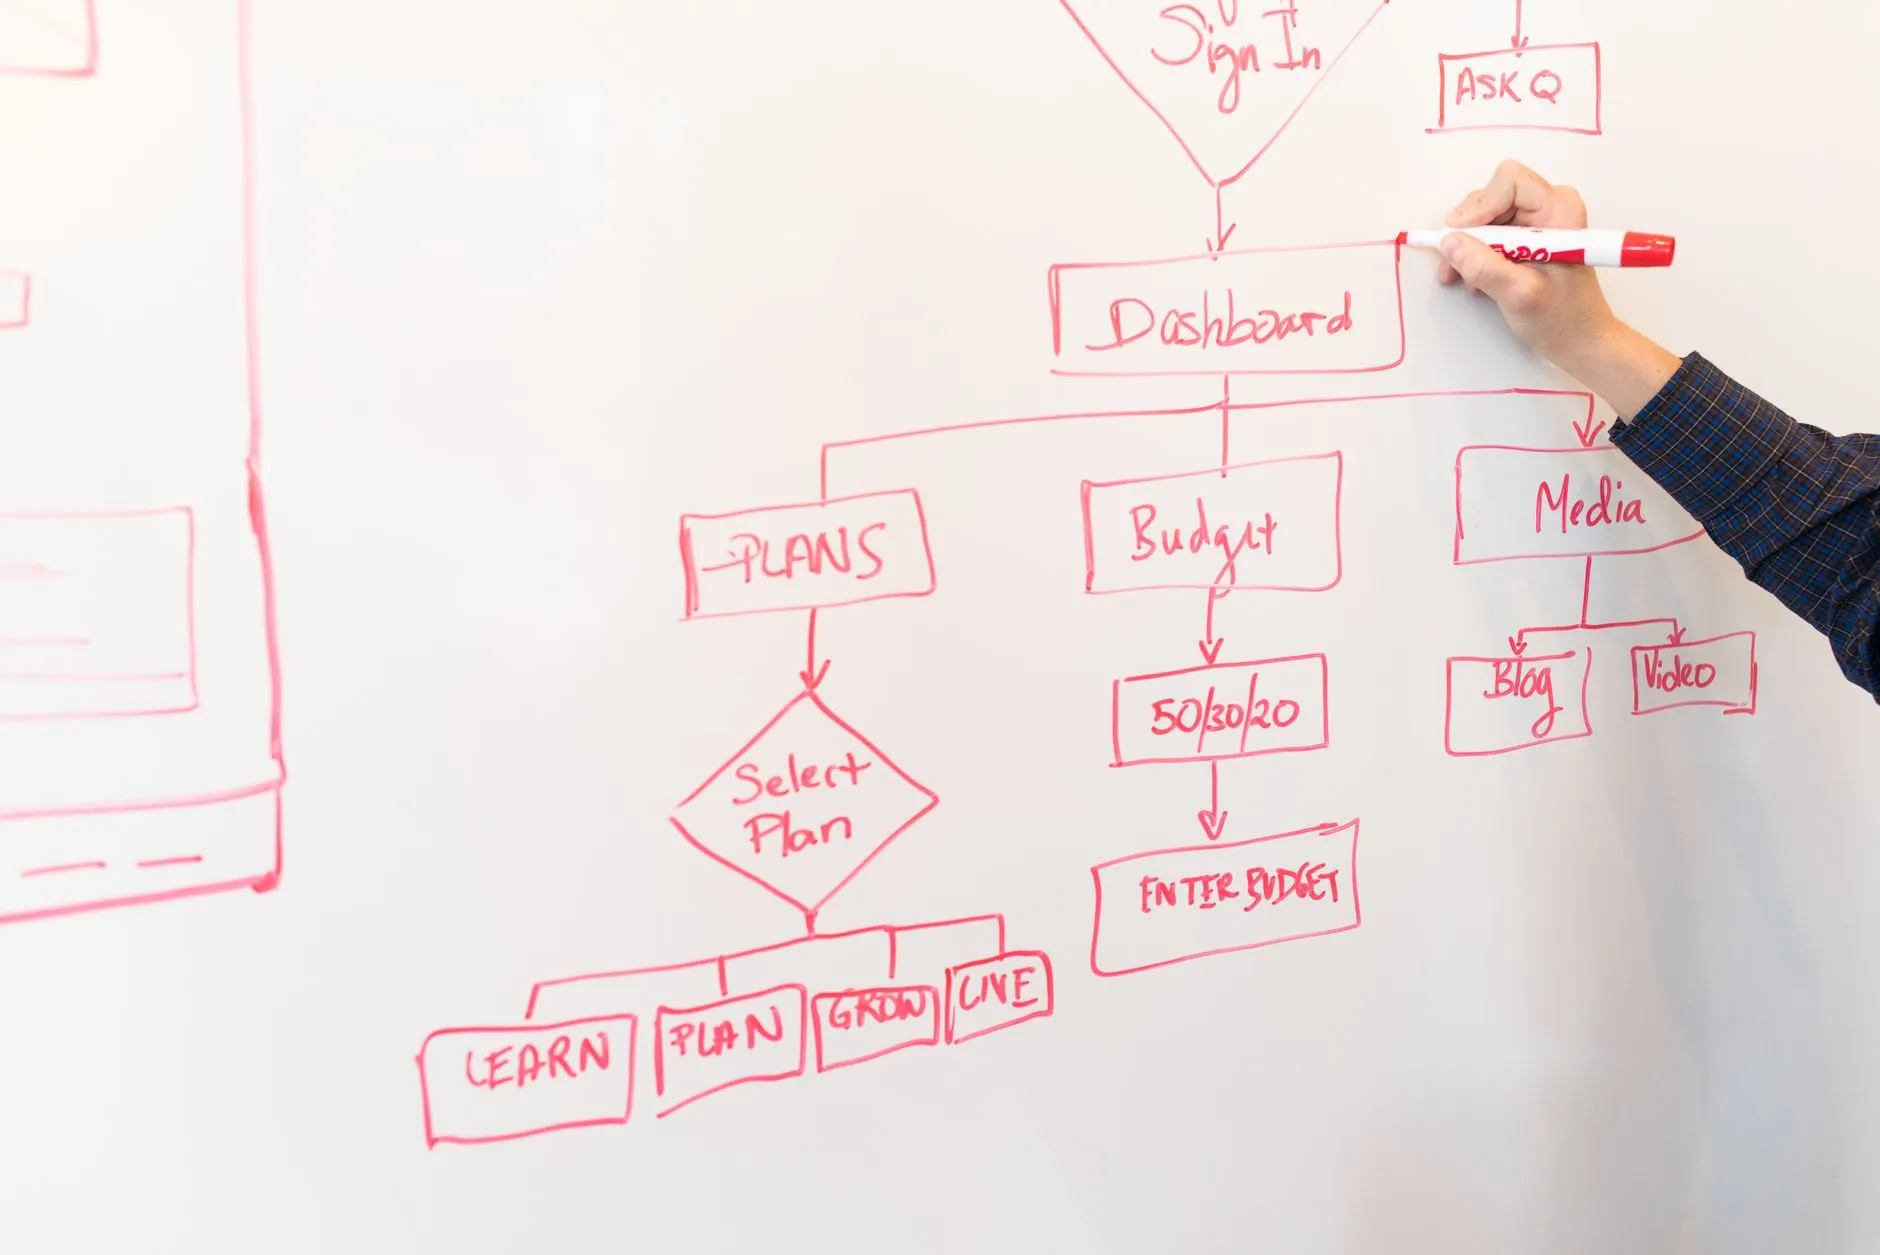
另一个关键参数是超时链的级联设置。负载均衡的proxy_read_timeout应略大于网关的upstream_response_time,否则网关还在等待下游慢响应时,负载均衡已先行断开,触发客户端无谓重试。我们曾在一家金融客户现场统计,仅将超时差值从3秒调到5秒,接口错误率就下降了0.42%。这类调优没有银弹,必须基于实际链路延迟分布来设定。
熔断降级与动态权重:从“各自为政”到“联合指挥”
单纯的流量分发解决不了服务雪崩。服务治理软件(如Sentinel、Resilience4j)提供的熔断降级能力,需要与负载均衡策略实时联动。常规做法是:当接口网关软件检测到某下游服务的错误率超过阈值(例如5秒内超过20%),立即触发熔断,同时通过控制面API通知负载均衡软件将该服务实例的权重临时降为0。但要注意,这种联动存在传播延迟——极端情况下,负载均衡仍会把新请求打进正在熔断的网关节点。
更稳健的方案是采用“客户端主动摘除”机制。在网关节点的本地缓存中维护一个“不可用服务列表”,负载均衡软件通过Consul或Eureka感知该列表,并同步调整自身的upstream server状态。这比事后通知快一个数量级。我们的实测对比显示,纯控制面联动需要800-1200ms完成摘除,而本地缓存方案可将这个数字压缩到150ms以内。
- API管理软件光盘中通常包含上述组件的离线安装包与策略模板,便于在隔离网络中快速搭建测试环境。
- 要特别留意网关与负载均衡的日志格式统一,否则排障时你会面对两套时间戳和Request-ID。
方案选型与落地建议:别迷信“全家桶”
市场上常见三类组合:一是Kong+Nginx,适合Kubernetes生态成熟、愿意维护Lua插件的团队;二是APISIX+OpenResty,性能强悍且动态上游更新支持好;三是Spring Cloud Gateway+Nacos,对Java技术栈友好,但高并发下网关吞吐量会打折扣。就我们的项目经验而言,若日均请求量低于2000万,完全不必引入独立负载均衡器,直接用网关的Cluster模式加VIP即可;超过这个量级,前置LVS或Nginx才具备成本优势。
最后提醒一点:熔断降级软件的配置阈值不能拍脑袋。建议从生产环境抓取一周的P99延迟和错误率数据,用直方图确定合理的熔断触发窗口。同时,在网关与负载均衡之间保留一条手动降级开关的SSH通道——自动化再完善,关键时刻能一键切流才是保命符。真正的协同,不是把所有功能塞进一个组件,而是让每个组件做它最擅长的事,并让它们之间的接口足够干净。